Menu
Relire les pull requests écrites par l'IA : par où commencer ?
- Les agents écrivent des pull requests plus vite qu’on ne peut les relire, et il faut choisir quels fichiers lire.
- Cribelo trace la carte de lecture d’une PR : ce qui reste à lire une fois le code déplacé mis de côté, ce que le diff ne montre pas, et dans quel ordre lire.
- Cribelo ne contient aucun LLM. Il repose sur l’analyse statique et l’historique git, donc le même diff donne le même plan sur toutes les machines, et ce plan peut aussi guider un reviewer IA.
- Je l’ai confronté à l’historique de 28 dépôts open source et aux commentaires de vrais reviewers.
Les pull requests arrivent plus vite et elles sont plus grosses, souvent parce qu’un agent IA les a écrites. Le nombre de relecteurs, lui, n’a pas bougé, et ils fatiguent.
Je ne suis pas le seul à le constater :
Les chiffres vont dans le même sens. Faros a suivi plus de 10 000 développeurs. Dans les équipes qui utilisent le plus l’IA, le nombre de PRs mergées augmente de 98 %, leur taille de 154 % et le temps de review de 91 %.
Il y a un an, je racontais ici comment une équipe était passée de dix-neuf jours à trois pour merger une pull request. Le problème a changé de forme depuis. Le temps consacré à la relecture n’augmente pas, alors on fait défiler le diff, on repère ce qui a l’air important et on relit ça. Tout relire n’est plus possible.
Ce tri dépend de choses qui n’ont rien à voir avec le risque : l’ordre alphabétique de l’onglet, les noms de fichiers qu’on reconnaît, l’heure de la journée. Le fichier qui a reçu sept commits de fix en trois mois se trouve quelque part au milieu, entre deux fichiers de tests. Rien ne le distingue des autres.
Je me suis donc posé une question simple : si je n’ai le temps de lire que cinq fichiers, lesquels choisir ?
J’ai essayé l’analyse statique, puis des modèles de machine learning maison, avant d’écrire Cribelo, un outil en ligne de commande qui répond à cette question. Voici le commentaire qu’il a posté sur une pull request d’AST Metrics, mon propre dépôt :
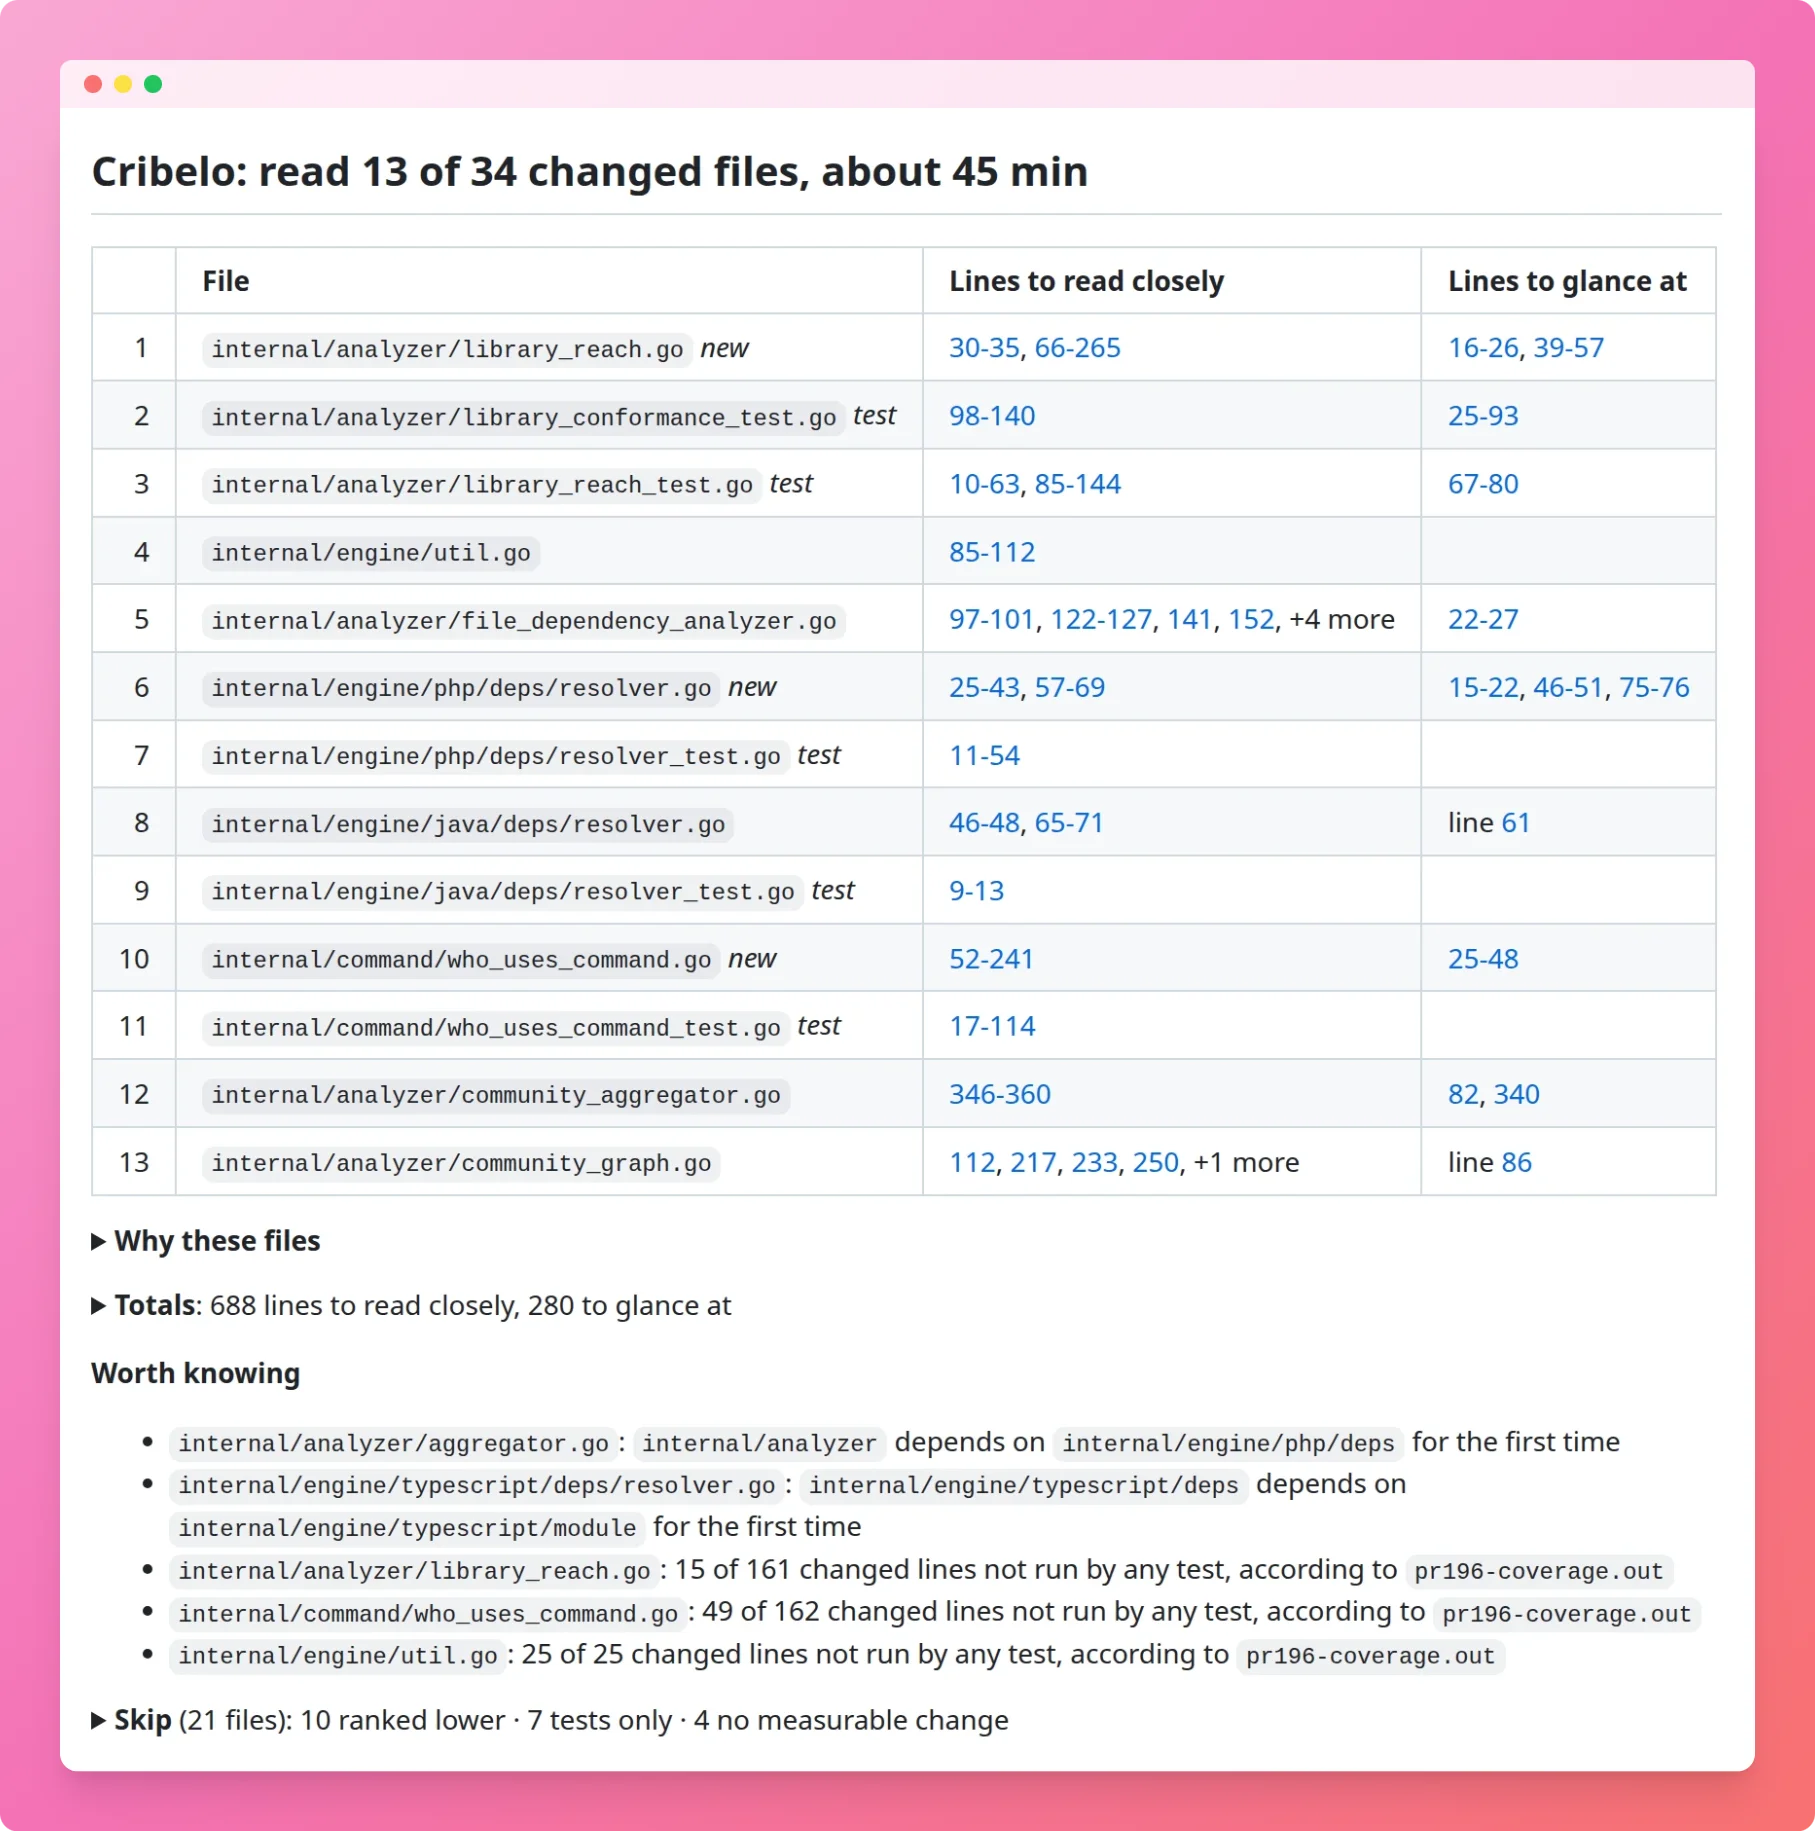
La PR modifie trente-quatre fichiers. Cribelo m’en fait lire treize, dans l’ordre où les lire, pour environ trois quarts d’heure. Pour chacun, il distingue les lignes à lire de près de celles qu’on peut survoler, et chaque plage ouvre le diff au bon endroit.
Les vingt et un autres fichiers sont listés avec la raison pour laquelle je peux les laisser de côté. Cribelo signale aussi qu’aucun test n’exécute les 25 lignes modifiées de util.go. Le diff, lui, ne le montre pas.
Le raisonnement est celui d’un relecteur expérimenté. Un fichier central, dont la complexité augmente, peu testé et souvent corrigé, mérite une vraie lecture. Du code déplacé, sans nouvel import ni nouvelle branche, peut attendre.
Pourquoi un reviewer IA ne suffit pas
J’utilise des outils de revue de code par IA, et ils ne résolvent pas ce problème. Ils commentent tout avec la même assurance, une coquille comme une régression dans l’agrégateur. Je me retrouve avec quarante remarques à lire en plus de la PR.
Ils sont aussi lents et chers. Relire une PR de cent fichiers revient à envoyer ces cent fichiers et leur contexte à un modèle, à chaque push.
Un petit modèle comme Jev, dont je parlais en septembre, est rapide et peu coûteux. Il lui manque en revanche le contexte global, puisqu’il ne juge que ce qu’on lui montre, un fichier ou un hunk. Il ignore que 83 fichiers importent celui-ci, que cette fonction a été corrigée sept fois dans l’année, ou qu’elle est la copie d’une autre que la PR ne touche pas.
Ce contexte, l’analyse statique le calcule en quelques secondes, sans GPU ni appel réseau : le graphe de dépendances, la complexité, les clones, l’historique git. Cribelo s’en sert pour indiquer où regarder, et s’en tient là. Il ne commente pas le code et ne suggère aucun refactoring.
Comme il ne contient aucun modèle de langage, le même diff produit le même plan sur votre machine, sur la mienne et dans la CI.
Les LLMs gardent leur place. Un reviewer IA à qui l’on donne six fichiers dans le bon ordre, avec les faits à vérifier, a plus de chances de dire quelque chose d’utile que s’il reçoit tout le diff. cribelo describe produit le plan en Markdown, prêt à être collé dans un prompt.
D’où vient l’idée
Je mesure du code depuis plus de dix ans, avec PhpMetrics puis AST Metrics. Ces métriques m’ont toujours laissé un regret : on les consulte après coup, dans un rapport, comme on lirait le bulletin météo de la veille.
La complexité, le couplage, les clones et l’historique des fix indiquent assez bien où les ennuis arriveront. Mais ils restaient enfermés dans un tableau de bord. Cribelo les affiche dans la PR, au moment où quelqu’un s’apprête à la relire.
L’outil est open source, sous licence MIT. Un outil qui juge votre code doit pouvoir être contredit : vous devez pouvoir lire le poids qui a placé un fichier en tête de liste et refaire le calcul. Le code de vos PRs reste chez vous, sans compte ni serveur.
Comment Cribelo choisit les fichiers à relire
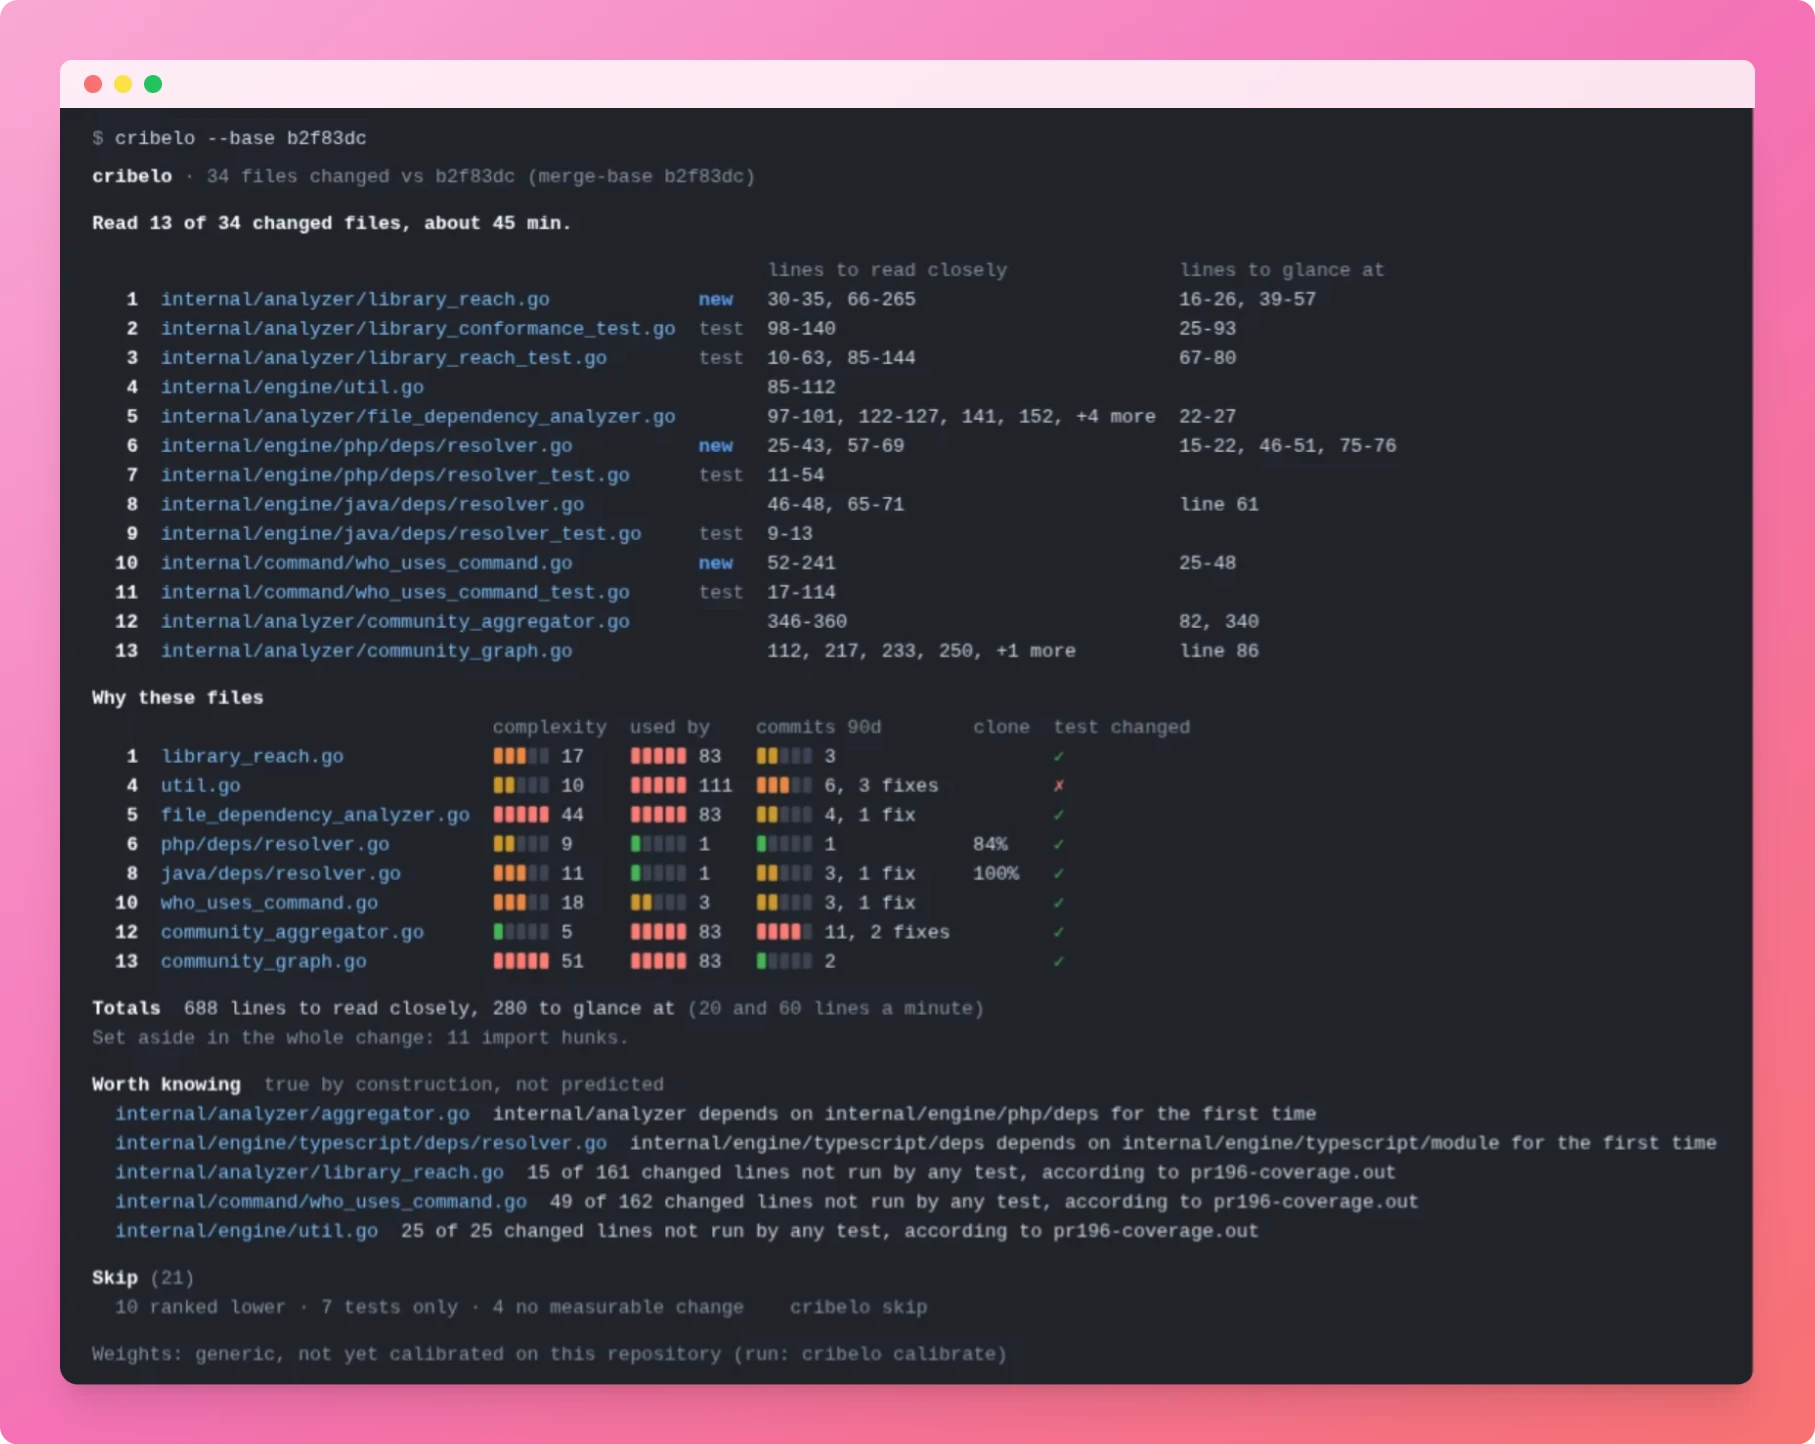
Cribellum signifie petit tamis en latin. Cribelo prend le diff de votre branche, parse l’avant et l’après avec les parseurs d’AST Metrics, puis procède en trois étapes. Voici la même pull request dans un terminal :
Étape 1 : ce qui reste vraiment à lire
Un diff compare des lignes. Reformatez un fichier, et git le montre en rouge et vert de haut en bas, alors que le programme fait exactement la même chose qu’avant. Cribelo compare des tokens, les mots du langage tels que le parseur les découpe. Quand les lignes retirées et les lignes ajoutées contiennent les mêmes tokens, espaces mis à part, c’est du formatage : il n’y a rien à lire.
Le code déplacé demande un peu plus de travail. Quand une fonction quitte un fichier et réapparaît ailleurs, Cribelo compare les deux corps token par token, noms de variables mis à part, et les apparie s’ils sont presque identiques. La méthode vient de RefDiff, un travail de Silva et Valente publié en 2017, qui détecte les refactorings par similarité de tokens sans avoir besoin des types. Elle reconnaît aussi une fonction extraite d’une autre, et un renommage appliqué de la même façon dans tout le changement.
Ces changements se vérifient d’un coup d’œil, et un fichier qui ne contient qu’eux rejoint les fichiers sautés, avec sa raison. Le reste modifie le comportement. Une fonction qui gagne une branche, ou qui était déjà complexe, se lit de près. Une fonction qui reste simple, sans nouvelle décision, se survole.
Étape 2 : les changements internes et d’architecture qu’un simple diff ne peut pas montrer
C’est le bloc Worth knowing. Il ne contient aucune prédiction, seulement des faits que vous pouvez vérifier en une minute :
- un import qui crée un cycle ;
- une fonction exportée dont la signature change alors que d’autres fichiers l’appellent ;
- une fonction modifiée dont un clone est resté intact ;
- une fonction déjà corrigée plusieurs fois dans l’année ;
- des lignes modifiées qu’aucun test n’exécute.
L’historique des fix vient de git log -L, qui suit une fonction à travers ses commits. La couverture vient du rapport de tests, quand il y en a un dans le dépôt.
Étape 3 : calculer l’ordre idéal de lecture
Les fichiers qui s’importent ou s’appellent forment un groupe. Dans un groupe, la définition passe avant ses usages et le test après le fichier qu’il couvre, parce qu’on comprend mieux un appelant quand on a déjà lu ce qu’il appelle.
C’est pour ça que le plan commence par library_reach.go. Le fichier est nouveau, il contient une fonction de complexité 17, et 83 autres fichiers en dépendent.
Cet ordre s’appuie sur les travaux de Baum, Schneider et Bacchelli sur l’ordre dans lequel relire les changements d’une revue de code. Les règles exactes de chaque étape sont détaillées dans how it is computed.
Ce que donnent les mesures
Pour vérifier que Cribelo ne se contente pas d’avoir l’air pertinent, j’ai rejoué avec cribelo backtest l’historique de 28 dépôts open source dans les sept langages, à raison de 2 500 merges par dépôt.
Sur 131 000 fonctions touchées, celles que Cribelo fait survoler ont été réparées par la suite dans 1,3 % des cas, contre 2,8 % pour celles qu’il fait lire de près. Le survol divise donc le risque par deux. Mais un tiers des fonctions réparées plus tard se trouvaient dans la partie survolée : il faut les survoler, pas les sauter.
J’ai aussi comparé les faits aux commentaires de vrais reviewers, sur 100 PRs de prometheus, pydantic, cargo et vite. En moyenne, 17 % des fichiers modifiés y reçoivent un commentaire. Pour les fichiers qui portent un clone, c’est quatre sur cinq. Pour ceux qui ont un historique de fix, un sur deux, et un sur trois quand une signature change.
Le tri du code mécanique retire peu sur une PR ordinaire : moins d’une ligne sur dix, même si un fichier sur sept n’a alors plus rien à lire. Il sert surtout sur les très gros changements. Dans ruff, la PR qui découpe types/class.rs déplace plus de 8 000 lignes sans que git détecte de renommage. Cribelo les met de côté.
Le détail des mesures est sur la page how it works.
L’essayer
curl -fsSL https://cribelo.github.io/install.sh | sh   # ou : brew install cribelo/tap/cribelo

cribelo                      # la carte de lecture de la branche courante
cribelo --budget 30m         # ce qui tient dans trente minutes
cribelo skip                 # les fichiers écartés, avec la raison
cribelo describe             # la carte en Markdown, pour la description de la PR
cribelo explain path/to/file # tout ce que Cribelo sait d'un fichier
Des binaires Linux, macOS et Windows sont sur la page des releases. Sept langages sont analysés pour l’instant : Go, PHP, Python, Rust, TypeScript, Java et C#. Si le vôtre manque, vous pouvez l’ajouter : le guide de contribution d’AST Metrics explique comment le brancher, et toute contribution est bienvenue.
Dans une pull request, douze lignes de YAML suffisent. Le plan arrive dans un seul commentaire, celui de la première capture, mis à jour à chaque push, et with: { budget: 30m } le limite au temps dont vous disposez.
name: cribelo
on: pull_request
permissions:
  contents: read
  pull-requests: write
jobs:
  cribelo:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
        with: { fetch-depth: 0 }
      - uses: cribelo/cribelo@v2
L’Action peut aussi faire échouer le job, si le temps de lecture dépasse un seuil (fail-over) ou si la PR contient certains faits (fail-on). Je conseille d’attendre quelques semaines avant de l’activer. Une équipe accepte volontiers un outil qui lui indique où regarder, beaucoup moins un outil qui refuse ses merges.
Pour commencer, lancez cribelo sur la dernière PR que vous avez approuvée en faisant défiler le diff, et regardez le premier fichier de la liste. L’aviez-vous ouvert ?
S’il se trompe, lancez cribelo backtest et postez le chiffre obtenu dans une issue, surtout s’il est mauvais. La prochaine version s’appuiera sur ces contre-exemples.
Un projet open source vit longtemps quand il est connu. Si Cribelo vous a montré un fichier que vous alliez laisser passer, laissez-lui une étoile sur GitHub. Et j’avoue que ça me fait vraiment plaisir :)
Soutenir mon travail
Sponsoring open-source
PHPMetrics, AST Metrics et le reste sont librement accessibles. Un petit coup de pouce sur GitHub aide à les faire vivre.
Me sponsoriser sur GitHub
Audit & Formation
Disponible sur Malt
Besoin d'un regard extérieur sur votre code ? J'accompagne les équipes PHP sur l'architecture, les tests et l'industrialisation, au rythme de vos projets.
Me trouver sur Malt© Jean-François Lépine, 2010 - 2026 · Flux RSS